光互联的全链路串联
跨机柜的数据旅程从芯片A的电信号开始。电信号进入光引擎,由电子集成电路(EIC)中的驱动电路完成信号整形与调制驱动,再交给光子集成电路(PIC)上的调制器、波导和光栅耦合器,把0、1比特加载到光载波上。这一步是整条链路中第一次光电转换,也是电世界与光世界的唯一接口。光从PIC出来后并不直接进光纤,而是先经过FAU(光纤阵列单元)。FAU由V型槽基板、压板和光纤构成,把几十根单模光纤以亚微米级精度排列固定,让每根光纤与芯片上的耦合点一一对准,对准偏差会直接转化为插入损耗和链路余量的损失,因此它既是耦合接口,也是决定量产良率的关键环节。光进入光纤后以约5ns/m的速度传播,纯光传输没有导体集肤效应带来高频损耗,也不存在铜缆的通道串扰,配合波分复用还能在单根光纤上叠加多个波长。到达对端机柜后,光再次经FAU耦合进接收侧光引擎,由光电探测器还原为电流,经跨阻放大器(TIA)放大后交给芯片B,完成第二次光电转换。整条链路只有两端落地成电,中间全程保持光域形态。
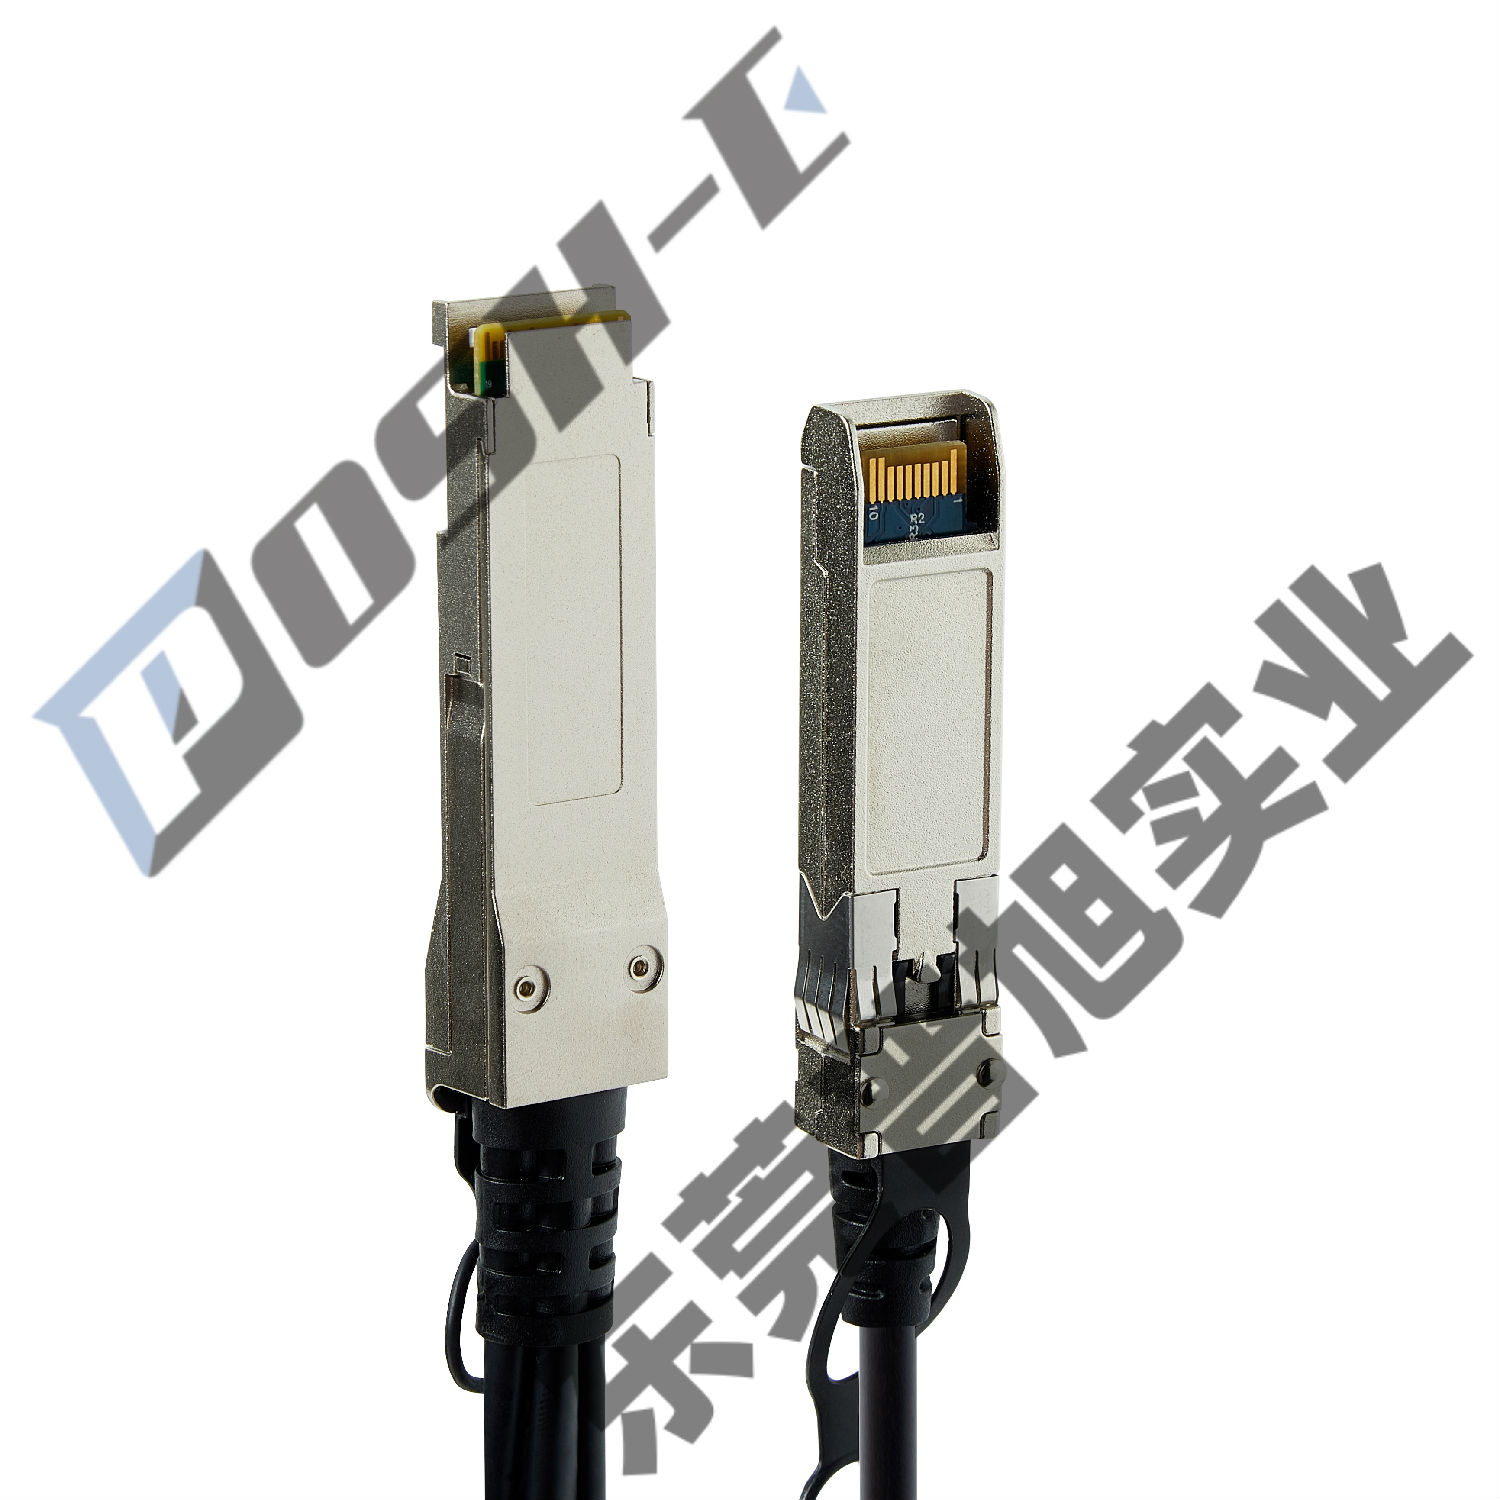
同机柜的短距场景走的是另一条路:芯片A(电)→ PCB背板或高速铜DAC → 芯片B(电)。全程不做光电转换,不需要光引擎、光纤和FAU。距离在铜缆可用范围内时,省去转换环节意味着更低的时延、更低的功耗和更简单的运维,这也是机柜内部仍以电互联为主的原因;一旦距离超出铜的可用范围,高频损耗和信号完整性就会成为硬约束,只能转向光。
光引擎的形态本身也在变化。传统可插拔光模块把转换放在面板上,电信号要在PCB上走较长距离;NPO、CPO则把光引擎逐步移近甚至共封装到交换ASIC或xPU旁边,缩短电通道长度,降低SerDes驱动功耗,代价是封装、耦合、散热和测试难度显著上升,单台设备所需FAU数量可达传统方案的3至5倍。
OCS解决的是中间调度的问题。传统O-E-O架构下,数据每经过一台交换机都要经历光→电解码→查表转发→电→光重发,每一跳都要落地处理,多级拓扑叠加后时延和功耗快速累积,大规模集群中网络设备能耗占比可达15%–30%。OCS在光域直接改写端口间的连接关系,不落地、不解包、不解析协议,只引入光速传播延迟,单跳时延可控制在百纳秒以内;由于功耗主要用于维持微镜角度,整机功耗远低于同吞吐规模的电交换机,谷歌Palomar实测约108W,而同等规模电交换机可达数千瓦。同时OCS对速率和调制格式透明,400G升级到800G、1.6T乃至3.2T时,中间光路硬件不必更换,只需替换两端光模块或光引擎,扩容也可以按1/8、1/4、1/2逐步填充。
OCS的局限同样明确:光路切换是毫秒级,无法做逐包调度和缓存,不适合小包随机流量和频繁变化的短流;它也不提供拥塞控制和流量整形,需要上层控制器根据作业通信模式提前规划并重构拓扑。因此工程上的主流选择是光电协同:Spine或聚合层用OCS承担大颗粒、长生命周期的流量调度和拓扑重构,Leaf或机柜内保留电交换提供包级转发与灵活调度,二者边界由流量特征决定,而不是由技术偏好决定。
把这条链路串起来看,分工是清晰的:光引擎负责光电边界的双向翻译,FAU负责芯片与光纤之间的高精度低损耗对接,光纤负责长距离低损耗搬运,OCS负责光层的连接重构,铜链路负责短距低成本互联。带宽、时延、功耗和可维护性之间的平衡,来自各器件在各自适用区间内工作,而不是某一种技术包揽全部场景。
Q1:跨机柜光互联的完整信号链路是怎样的?
A1:电信号经光引擎内的驱动电路和调制器完成第一次光电转换,再由FAU光纤阵列以亚微米精度耦合进光纤,全程光域传输到对端。对端经FAU耦合回接收光引擎,由探测器和跨阻放大器还原为电信号,完成第二次光电转换。
Q2:同机柜短距场景为什么通常不走光互联?
A2:短距走PCB背板或高速铜缆,全程不做光电转换,时延更低、功耗更小、运维更简单。只有距离超出铜缆可用范围时,才需要转向光互联。
Q3:光引擎的形态正在如何演变?
A3:从面板上的可插拔光模块,逐步演进为贴近甚至共封装在交换芯片旁的NPO、CPO,以缩短电通道、降低驱动功耗。代价是封装、耦合、散热和测试难度上升,单台设备所需FAU数量可达传统方案的3至5倍。
Q4:OCS光电路交换的核心优势是什么?
A4:OCS在光域直接改写端口连接关系,不落地、不解包,单跳时延可控制在百纳秒内,功耗远低于同吞吐规模的电交换机。它对速率和调制格式透明,升级800G、1.6T时中间光路硬件无需更换。
Q5:OCS有哪些局限?工程上如何落地?
A5:OCS切换为毫秒级,无法逐包调度和缓存,也不提供拥塞控制,不适合小包随机流量。主流做法是光电协同:Spine层用OCS做大颗粒拓扑重构,Leaf层保留电交换负责包级转发。
下一篇:已经是最后一篇了上一篇:高速光互联中的线缆方案


最新产品


同类文章排行
- 光互联的全链路串联
- 高速光互联中的线缆方案
- USB-C转TOSLINK光纤线制作工艺
- TOSLINK接收适配设备
- 阳极铝壳设计场景
- 光纤延长器的特殊场景
- 光纤延长器核心优势
- 光纤延长器是什么
- 极细同轴HDMI弹簧弯头线特殊场景
- 极细同轴hdmi弹簧弯头线制作工艺难点
最新资讯文章
您的浏览历史
